关注公众号【算法码上来】,每日算法干货马上就来!
论文链接:P17-2027
摘要
这篇论文介绍了一种新奇的、隐式定义神经网络,并且描述了计算它的方法。
1 介绍
传统的双向RNN只能单独计算两个方向的隐含层,现在介绍一种新的机制,将两个方向的信息直接结合起来计算。
2 INN
2.1 传统的RNN
经典的RNN给定一个输入序列$[{\xi _1},{\xi _2}, \ldots ,{\xi _n}]$和初始隐含层状态${h_s}$,然后迭代产生后续的隐含层状态:
<!–swig2–>LSTM、GRU和其他的相关变体计算方法也都类似,都是像下图这样线性计算,每一时刻的状态只依赖于当前输入和前一时刻的状态。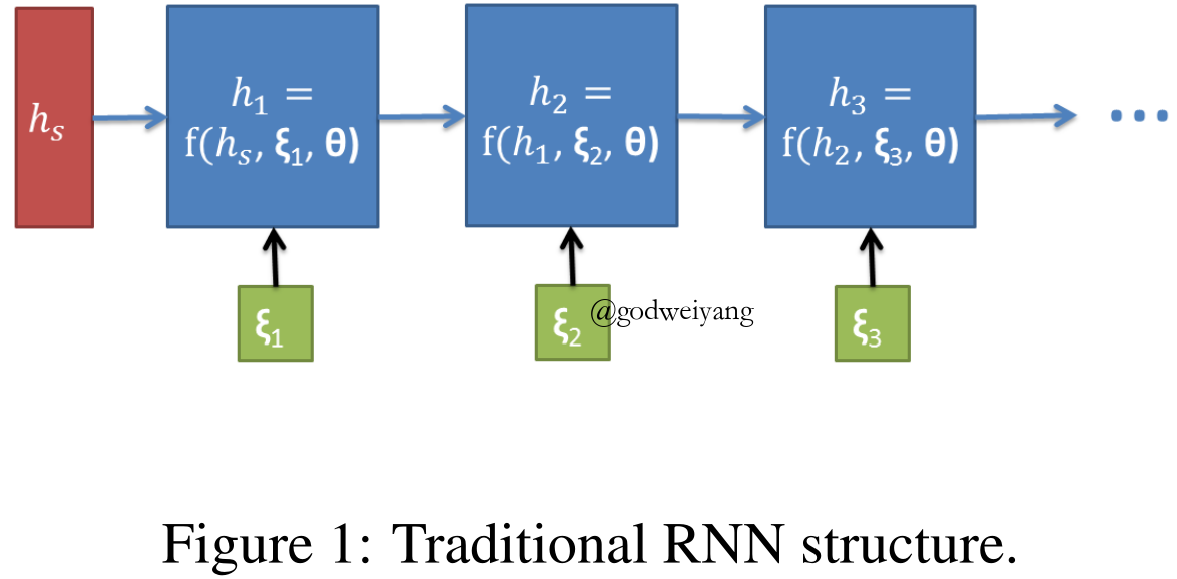
2.2 改进结构
这篇论文中这样计算隐含层状态:
<!–swig3–>这样整个隐含层状态序列的等式就是隐式的,记为:
<!–swig4–>在这个神经网络中,定义如下变量:数据$X$、标签$Y$、参数$\theta$,定义如下函数:
输入层变换:
<!–swig8–>隐式隐含层:
<!–swig9–>损失函数:
<!–swig10–>定义${h_s}$和${h_e}$为边界状态,$n$为输入序列长度,$F$函数构造出了一系列非线性等式:
<!–swig15–>INN结构如下图: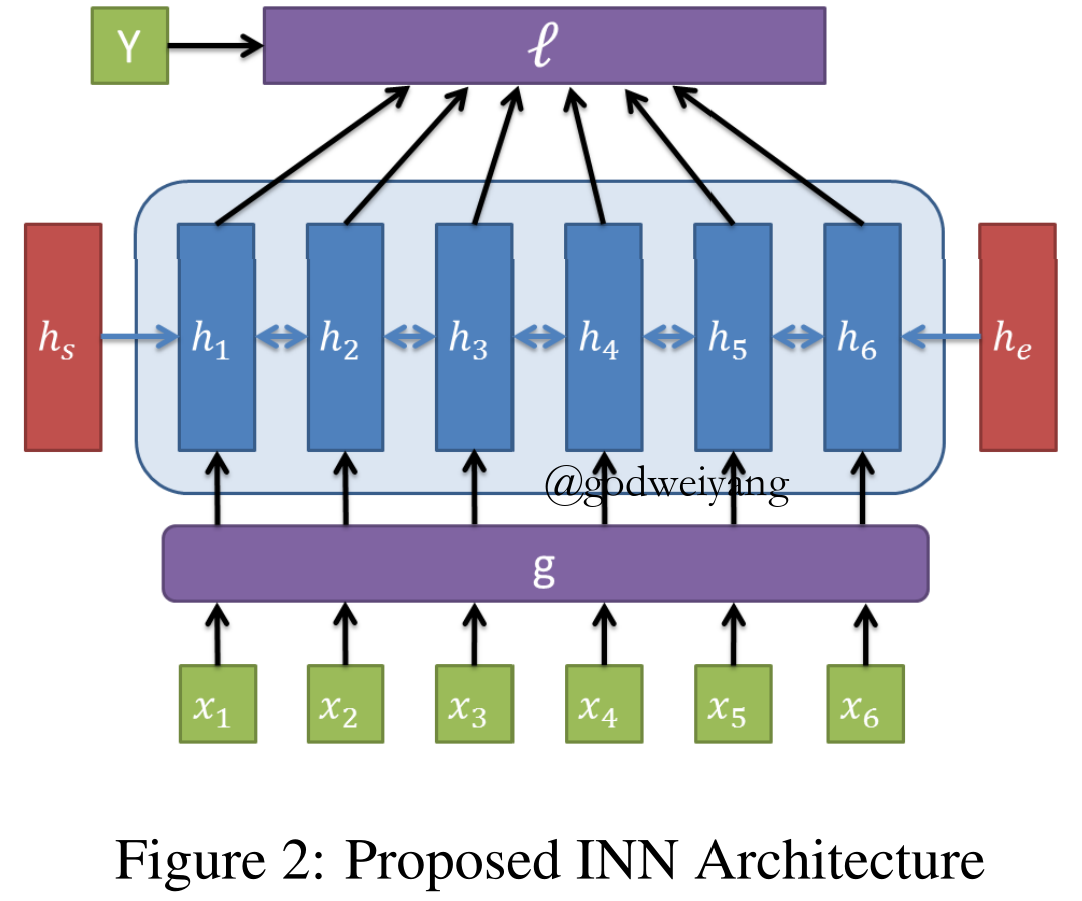
2.3 计算前向传播
为了计算等式$H = F(H)$,采用拟牛顿法。
令$G = H - F(H)$,转化为计算等式$G = 0$。
<!–swig19–>注意到$(I - {\nabla _H}F)$是一个稀疏矩阵,所以采用Krylov子空间方法,具体是稳定双共轭梯度法(BICG-STAB)算法来计算。
2.4 梯度
为了训练模型,采用随机梯度下降,定义损失函数:
<!–swig21–>其中
<!–swig22–>所以
<!–swig23–>所以整个梯度就是
<!–swig24–>
2.5 转换函数
回忆在GRU中,有如下转换函数:
<!–swig25–>其中在GRU中${ {\hat h}_t} = {h_{t - 1}}$,在INN中做一个替代:
<!–swig27–>
3 实验
序列标注
如下图所示,这个模型的效果甚至比标准的序列标注器还要好!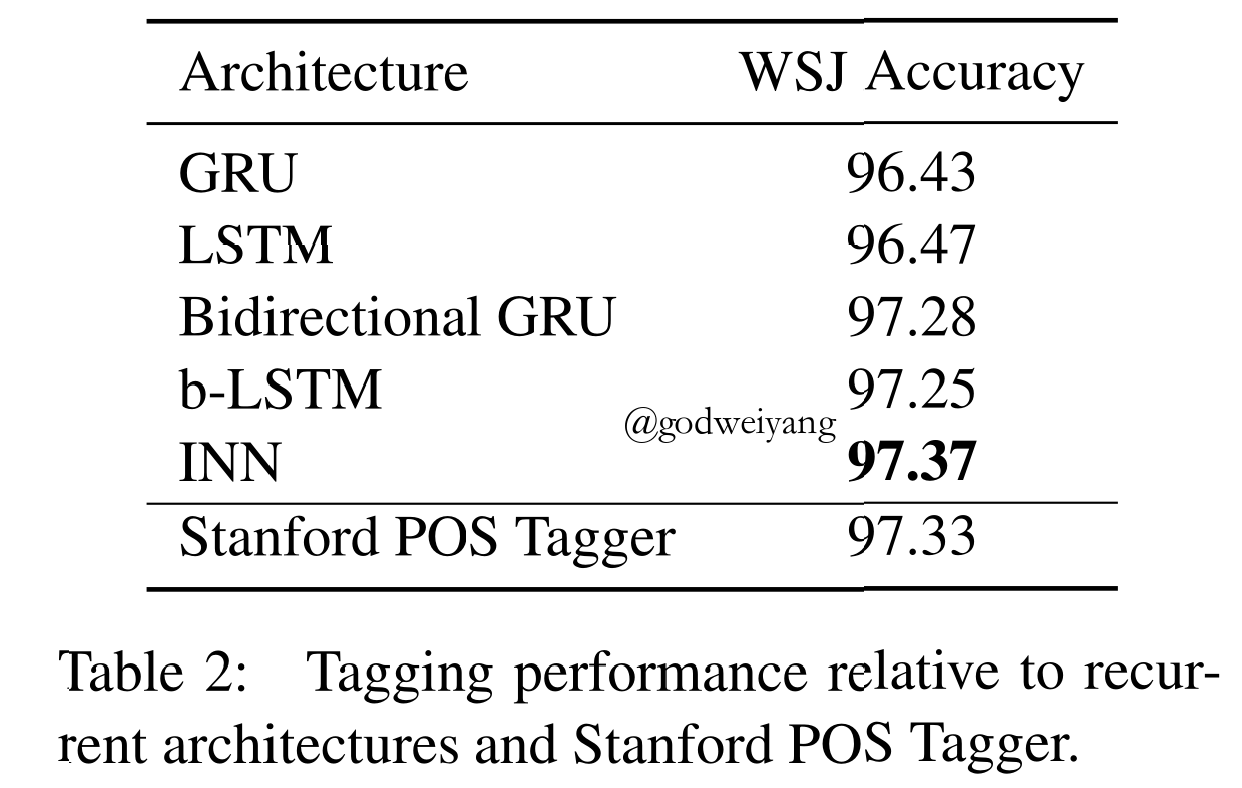
4 结论
介绍了一种隐式定义神经网络,应用到了序列标注任务上,效果比双向LSTM、双向GRU等还要好。
还有一些工作可以改进,比如可以在双向LSTM上面改造INN,加速计算${(I - {\nabla _H}F)^{ - 1}}$等等。